A10 AI Gatewayの強み
ユーザーやチーム単位でLLMへのリクエストを最適に振り分け・制御し、
処理の高速化とコスト効率の最大化を実現

1つの接続で、あらゆる
AIモデルを利用可能に
AI Gatewayが複数のAIモデルへの接続窓口を一元化することで、アプリ側のコード変更なしで新しいAIモデルやプロバイダーをいつでも追加・切り替えできます。

パフォーマンスを犠牲にせず
AIコストを削減
AI Gatewayが各リクエストを、最もコスト効率が高く高性能なAIモデルへとルーティング。
難易度の変化に応じてターンごとに切り替えも可能なため、パフォーマンスを犠牲にせずに過剰なコストを抑制することもできます。

企業に必要なガバナンス提供
AI Gatewayが、部署やユーザーごとに予算や利用制限を設定した仮想キーで認証を行います。
これにより、管理者はモデル別・部署別・ユーザー単位でのコストや利用状況を正確に把握・コントロールできます。
主な機能
複雑度を考慮したルーティング
シンプルなプロンプトに適したAIモデル、複雑なプロンプトに適したAIモデルなど、プロンプトの複雑度に応じて最適なAIモデルへ自動的にルーティングします。
優先順位チェーンによるカスケード
予算を使い切ると、あらかじめ設定した優先順位に従ってリクエストを次のモデルへ自動で切り替え。手動での対応なしでスムーズに処理を継続します。
仮想APIキー
組織の認証基盤(IAM)と連携し、ユーザーごとに予算や利用制限をセットした専用の仮想キーを発行。既存のアカウント情報をそのまま活用できるため、追加の設定作業なしで、誰がどれだけAIを使えるかを安全に制御できます。
Provider Credential Vault
(プロバイダー認証情報保管庫)
OpenAI、Anthropic、Azureなどのアップストリーム認証情報は、設定ファイルではなく、OpenBaoバックエンドのVault(保管庫)に格納されます。
リアルタイムのコスト追跡
リクエストのルーティング中にも支出をリアルタイムで追跡。チームは即座に消費したコストを把握できます。
トークン予算
個々のモデル、ユーザー、チームの各レベルで支出に上限を設定。高価格AIモデルの利用を抑制しつつ、予算に合うAIモデルを自由に試すことができます。
ビジネスレイヤーのレート制限
キーまたはチームごとにRPM(Requests Per Minute)とTPM(Tokens Per Minute)の上限を設定。過剰なリクエストを送るクライアントから共有プロバイダーの資源消費を保護したり、不要なコストの発生を抑制します。
シングルテナント展開
Oracle Kubernetes Engine上にHelmで展開し、完全なテナント分離を実現。GPUは必須ではありませんが、GPUを活用した拡張オプションも利用可能です。
A10 AI Gatewayにおけるリクエスト処理フロー
複雑度と予算を考慮した
スマートルーティング
すべてのリクエストは、モデルに到達する前に分類、チェック、ルーティングされます。
リクエストは仮想キーで入力され、複雑度に応じて分類され、予算と照合されます。その後、最適なプール内で対応可能な最も低コストのモデルにルーティングされ、予算を使い切った場合は自動的にフォールバックします。各ステップはコスト追跡と監査のために記録されます。
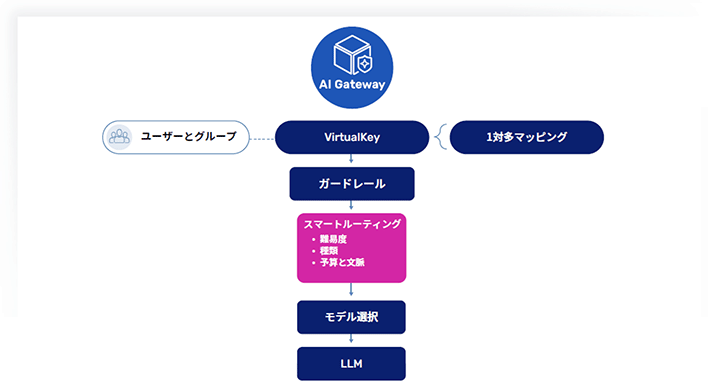
軽量分類器(lightweight classifier)が各プロンプトの複雑度をリアルタイムでスコアリング。最適なモデルプールへルーティングします。単純なタスクは小型で高速なモデルへ、複雑なタスクはより高性能なモデルへ振り分けます。ユーザーが手動でモデルを選択する必要はありません。
いいえ。AI Gatewayは複数のモデル間でコンテキストを調整できるため、同じ会話内の異なるリクエストが別々のモデルにルーティングされても、それぞれのモデルは正確に応答するために必要な過去のコンテキスト全体を参照できます。
リクエストは、設定した優先順位チェーン内で対応可能な次に低コストのモデルへ自動的に振り分けられるため、手動による介入なしでトラフィックは流れ続けます。
いいえ。分類とルーティングは十分に高速に行われるため、AI Gatewayは一般的なリクエストを低い追加遅延で処理できます。
Helmを使用してOracle Kubernetes Engine上に展開され、シングルテナントオプションにより、各顧客は完全に専用化された隔離環境で実行できます。
A10 AI Gatewayには、設定可能なルールに基づいてリクエストとレスポンスをチェックする、軽量なパターンベース(正規表現)のフィルタリングが含まれており、ポリシーの進化に合わせてより強力なガードレールを追加できる余地があります。
関連製品
TrojAI by A10 Networks
TroJAI by A10 Networksは、エージェント駆動型の自動レッドチーミングと、MCPサーバー、ツール、エージェントを検出、発見、制御する機能により、ビルドからランタイムまで、すべてのAIエージェント、アプリケーション、モデルを保護します。